
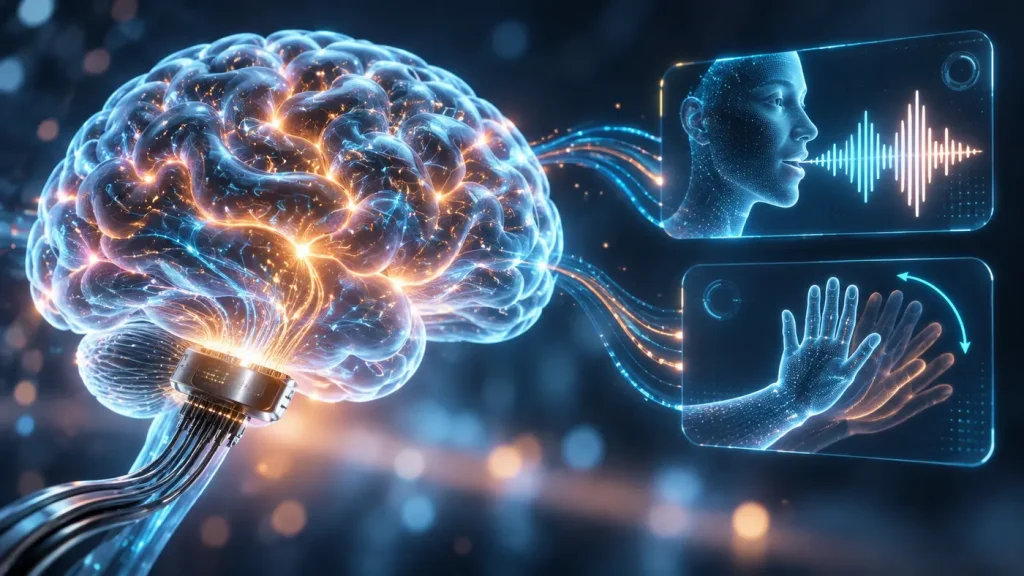
Naukowcy z University of California, San Francisco pokazali interfejs mózg–komputer, który potrafi jednocześnie odczytywać zamiar wypowiedzenia słów i wykonania gestów, a następnie odtwarzać oba kanały komunikacji za pomocą wirtualnego awatara. To ważna zmiana względem wcześniejszych systemów BCI, które koncentrowały się przede wszystkim na jednym zadaniu naraz — mowie albo ruchu.
System wykorzystuje implant ECoG umieszczony na powierzchni kory mózgowej oraz modele uczenia maszynowego analizujące aktywność związaną z mową i ruchami górnej części ciała. W badaniu uczestniczyły trzy osoby z ciężkim paraliżem, a u dwóch z nich naukowcy pokazali działającą w czasie rzeczywistym komunikację z wykorzystaniem spersonalizowanego awatara. To nadal eksperymentalny proof of concept, ale po raz pierwszy pojedynczy implant pozwolił odtwarzać oba elementy naturalnej komunikacji jednocześnie.
Najważniejsze informacje:
- BCI odczytuje mowę i gesty równocześnie z jednego implantu.
- Badanie przeprowadzono na trzech osobach z ciężkim paraliżem.
- U dwóch uczestników system sterował w czasie rzeczywistym pełnopostaciowym awatarem.
- Implant rejestrował sygnały z kory sensomotorycznej za pomocą ECoG.
- Modele musiały zostać nauczone nie tylko osobnej mowy i gestów, ale również ich jednoczesnego wykonywania.
- Kolejnym krokiem zespołu ma być przetestowanie w pełni wszczepialnej, bezprzewodowej wersji systemu.
Jeden implant potrafi odczytać jednocześnie mowę i gesty
Naturalna rozmowa prawie nigdy nie składa się wyłącznie ze słów. Człowiek kiwa głową, wzrusza ramionami, wskazuje kierunek, unosi kciuk, macha dłonią i wykorzystuje mimikę, aby dopowiedzieć rzeczy, których nie musi wypowiadać. U osób z ciężkim paraliżem utrata ruchu może więc odebrać znacznie więcej niż samą zdolność mówienia.
Dotychczasowe interfejsy mózg–komputer potrafiły już rekonstruować mowę, sterować kursorem, ramieniem robota, ruchami twarzy czy prostymi gestami. Problem polegał na tym, że większość tych systemów była projektowana do jednego rodzaju działania na raz.
Zespół Edwarda Changa z UCSF sprawdził, czy jeden implant może obsłużyć kilka systemów ruchowych jednocześnie. Elektrody rozmieszczono nad dużym fragmentem kory sensomotorycznej, dzięki czemu urządzenie mogło rejestrować aktywność związaną zarówno z artykulacją i ruchami twarzy, jak i z rękami czy górną częścią ciała.
Rezultat pokazuje, że taki wielokanałowy odczyt jest możliwy. Ta sama siatka elektrod może dostarczać wystarczająco dużo informacji, aby równocześnie dekodować zamiar wypowiedzenia określonej frazy i wykonania gestu.
System nie czyta „myśli” w dowolnym znaczeniu
Przy tego rodzaju badaniach bardzo łatwo użyć określenia „czytanie myśli”, ale byłoby ono zbyt szerokie. Implant nie odczytuje dowolnych treści pojawiających się w głowie uczestnika ani jego prywatnego wewnętrznego monologu.
System został wytrenowany na konkretnych próbach wykonania określonych ruchów i wypowiedzenia konkretnych fraz. Uczestnicy otrzymywali polecenie, aby spróbować powiedzieć słowo albo zdanie, wykonać gest lub zrobić obie rzeczy jednocześnie. Algorytm uczył się następnie charakterystycznych wzorców aktywności mózgowej odpowiadających poszczególnym zachowaniom.
U jednego uczestnika badacze wykorzystywali pięć wypowiedzi i cztery gesty, u drugiego — dziesięć wypowiedzi i dziesięć gestów. W bardziej rozbudowanym zestawie dawało to nawet 100 różnych kombinacji mowy i gestu.
To nadal ogromny krok, ale jego znaczenie polega na czymś innym niż odczytywanie wszystkiego, o czym myśli człowiek. BCI rekonstruuje intencję wykonania określonego działania komunikacyjnego na podstawie sygnałów motorycznych kory mózgowej.
Wirtualny awatar mówi i gestykuluje razem z użytkownikiem
Najbardziej widowiskowym elementem badania jest pełnopostaciowy awatar. Zamiast ograniczyć wynik do tekstu wyświetlanego na ekranie, naukowcy połączyli dwa dekodery — mowy i gestów — z animowaną cyfrową postacią reprezentującą użytkownika.
Jeżeli uczestnik próbował powiedzieć „hello” i jednocześnie pomachać ręką, system mógł rozpoznać oba zamiary i przekazać je do awatara. Przy odpowiedzi „yes” można było równocześnie odtworzyć skinienie głową. System obsługiwał także wzruszenie ramionami, uniesienie kciuka i inne proste ruchy komunikacyjne.
W demonstracji konwersacyjnej użytkownik kontrolował własnego awatara, natomiast drugi awatar był sterowany przez eksperymentatora. Wypowiedzi pojawiały się również jako tekst w czacie, a gesty były animowane na postaciach i zapisywane w historii rozmowy.
To może wydawać się detalem, ale w praktyce mowa ciała przekazuje dużą część emocjonalnego i społecznego kontekstu rozmowy. System, który ogranicza użytkownika wyłącznie do generowania tekstu lub syntetycznej mowy, przywraca komunikację, ale nie całą jej naturalną ekspresję.
Jednoczesna mowa i gesty okazały się trudniejsze niż dwa osobne zadania
Jedno z najważniejszych odkryć dotyczy sposobu, w jaki mózg koduje jednoczesne zachowania. Badacze początkowo sprawdzili, czy można nauczyć model rozpoznawać mowę i gesty oddzielnie, a następnie po prostu uruchomić oba dekodery równocześnie.
Okazało się, że nie działa to wystarczająco dobrze.
Wzorce aktywności podczas jednoczesnej próby mówienia i gestykulowania nie są po prostu prostą sumą sygnału „mowa” oraz sygnału „gest”. Część aktywności się nakłada, a sposób pracy kory sensomotorycznej zmienia się zależnie od kontekstu.
Modele trenowane wyłącznie na osobnych zadaniach radziły sobie więc wyraźnie gorzej, gdy uczestnik próbował robić obie rzeczy jednocześnie. Dopiero dodanie do treningu danych obejmujących faktyczne kombinacje mowy i gestów znacząco poprawiło wyniki.
To ważne także z punktu widzenia przyszłych neuroprotez. Jeżeli urządzenie ma działać w codziennym świecie, nie wystarczy nauczyć go zestawu pojedynczych komend. Musi ono rozpoznawać zachowania wykonywane równolegle i w naturalnym kontekście.
Wyniki były znacznie lepsze po odpowiednim treningu modeli
Najlepiej pokazują to liczby z publikacji. U jednego z uczestników, oznaczonego jako Bravo-6, offline’owa dokładność podczas jednoczesnych prób wynosiła około 68,8 proc. dla gestów i 77,5 proc. dla mowy. U drugiego uczestnika wyniki sięgały odpowiednio około 88,3 proc. i 84 proc.
W czasie rzeczywistym dla Bravo-6 system osiągnął około 66 proc. dokładności dekodowania gestów i 70 proc. mowy podczas prób, w których oba działania wykonywano jednocześnie. W bardziej naturalistycznym eksperymencie konwersacyjnym średnia dokładność wynosiła odpowiednio 85 proc. dla gestów i 75 proc. dla mowy.
Nie są to jeszcze wartości pozwalające mówić o bezbłędnym systemie do codziennego użytku. Badanie pokazuje jednak, że jedna implantowana siatka elektrod dostarcza wystarczająco bogatego sygnału, aby obsłużyć dwa różne kanały komunikacyjne równocześnie.
Najważniejsze jest również to, że poprawa nie wymagała wszczepienia dwóch oddzielnych implantów. Ten sam interfejs obejmujący szeroki fragment kory sensomotorycznej był w stanie odczytywać aktywność odpowiadającą różnym częściom ciała.
Implant rejestruje sygnały bezpośrednio z powierzchni mózgu
Technologia wykorzystuje elektrokortykografię, czyli ECoG. Elektrody są chirurgicznie umieszczane na powierzchni kory mózgowej, dzięki czemu rejestrują aktywność neuronalną znacznie dokładniej niż urządzenia znajdujące się poza czaszką, np. klasyczne EEG.
W opisywanym systemie zastosowano gęstą siatkę elektrod obejmującą dużą część kory sensomotorycznej. Nature opisuje implant używany u uczestników jako układ zawierający 253 elektrody.
To kompromis pomiędzy bardziej inwazyjnymi implantami wprowadzanymi bezpośrednio do tkanki mózgowej a całkowicie zewnętrznym pomiarem. ECoG wymaga operacji neurochirurgicznej, ale elektrody pozostają na powierzchni mózgu i mogą jednocześnie pokrywać stosunkowo duży obszar.
W tym przypadku właśnie szeroki zasięg okazał się kluczowy. Aktywność związana z mową była silniejsza w bardziej dolnych fragmentach kory ruchowej, natomiast gesty angażowały obszary związane z rękami i ramionami. Część elektrod reagowała jednak na oba rodzaje zachowania, pokazując, że granice pomiędzy nimi nie są całkowicie oddzielone.
Badanie objęło trzy osoby z ciężkim paraliżem
Eksperymenty przeprowadzono u trzech uczestników z przewlekłym, ciężkim paraliżem. Przyczyny ich ograniczeń ruchowych były różne, co pozwoliło sprawdzić, czy sygnały związane z wieloma częściami ciała można nadal znaleźć w korze mimo znacznej utraty funkcji ruchowych.
Jeden z uczestników miał zaburzenia mowy i ruchu wynikające z udaru pnia mózgu. Drugi cierpiał na stwardnienie zanikowe boczne — ALS — powodujące postępujący paraliż aparatu mowy i mięśni ciała. W zależności od możliwości konkretnej osoby badacze prosili ją o faktyczną próbę ruchu, wyobrażenie gestu albo próbę wypowiedzenia określonej frazy.
To ważny aspekt całej technologii. Człowiek może stracić zdolność fizycznego wykonania ruchu, ale odpowiednie obszary mózgu nadal mogą generować charakterystyczną aktywność, gdy próbuje albo wyobraża sobie wykonanie tej czynności.
Interfejs mózg–komputer próbuje przejąć rolę uszkodzonego połączenia pomiędzy mózgiem a ciałem: zamiast przesyłać polecenie do mięśni, sygnał zostaje przechwycony i przetłumaczony na działanie urządzenia cyfrowego.
Dla osób z ALS i po udarach obecne metody mają poważne ograniczenia
Osoby z ALS lub ciężkimi uszkodzeniami pnia mózgu mogą zachować pełną świadomość i zdolność formułowania myśli, jednocześnie stopniowo tracąc kontrolę nad mową oraz ciałem.
W najbardziej zaawansowanych przypadkach komunikacja opiera się m.in. na systemach śledzenia ruchu oczu, dzięki którym użytkownik może wybierać litery albo sterować syntezą mowy. Technologia ta jest niezwykle cenna, ale pozostaje stosunkowo wolna i może być męcząca przy długim użytkowaniu. NIH wskazuje również, że pozwala ona przekazać znacznie mniej pozawerbalnych informacji niż normalna rozmowa.
Interfejs BCI może docelowo skrócić drogę pomiędzy intencją a wypowiedzią. Zamiast wybierać litery wzrokiem, użytkownik próbuje mówić, a model rekonstruuje odpowiednią treść bezpośrednio z aktywności neuronalnej.
Dodanie gestów rozszerza ten model jeszcze bardziej. Człowiek nie musi ograniczać się do komunikatu „tak”. Potencjalnie może powiedzieć „tak” i jednocześnie skinąć głową, tak jak zrobiłby to przed wystąpieniem paraliżu.
To krok w stronę przywracania bardziej naturalnej komunikacji
Właśnie ten element jest najważniejszy z perspektywy całego badania. Twórcy nie próbują wyłącznie zwiększać liczby słów dekodowanych na minutę. Chcą odtworzyć wielowarstwowość ludzkiej komunikacji.
Rozmowa obejmuje ton, mimikę, ruchy głowy, rąk i ciała. Czasami gest zastępuje zdanie, czasami wzmacnia jego znaczenie, a czasami przekazuje coś zupełnie innego niż wypowiadane słowa.
System UCSF jest jeszcze bardzo ograniczony w porównaniu z rzeczywistą rozmową, ale po raz pierwszy pokazuje, że różne kanały można łączyć wewnątrz jednego BCI.
W przyszłości podobna neuroproteza mogłaby jednocześnie sterować głosem, twarzą awatara, rękami, mimiką i innymi elementami cyfrowej reprezentacji człowieka. Nie wszystkie te funkcje muszą nawet wymagać oddzielnych implantów, jeżeli odpowiednio szeroka siatka elektrod dostarcza wystarczająco dużo sygnałów z różnych obszarów ruchowych.
Kolejna wersja ma być bezprzewodowa i w pełni wszczepialna
Obecny prototyp nie jest jeszcze urządzeniem przeznaczonym do normalnego użytkowania poza laboratorium. Implant jest połączony przewodowo z zewnętrznymi jednostkami odpowiedzialnymi za rejestrowanie i przetwarzanie sygnałów.
Edward Chang zapowiedział jednak, że zespół przygotowuje się do testowania w pełni implantowanej, bezprzewodowej wersji systemu. Taki projekt ma znacznie większy potencjał do długotrwałego wykorzystania, ponieważ nie wymagałby stałego fizycznego połączenia pomiędzy mózgiem a aparaturą laboratoryjną.
To właśnie przejście z demonstracji laboratoryjnej do stabilnego, codziennego urządzenia pozostaje jednym z największych wyzwań wszystkich BCI. System musi działać nie tylko przez kilka sesji, ale przez miesiące i lata, zachowywać jakość sygnału i wymagać minimalnej kalibracji.
Do tego dochodzą kwestie bezpieczeństwa zabiegu, trwałości implantu, zużycia energii oraz sposobu aktualizowania modeli dekodujących. Dlatego mimo imponujących wyników nie jest to technologia gotowa dziś do powszechnego leczenia osób z paraliżem.
Największym ograniczeniem badania jest niewielka liczba uczestników
Badanie jest przede wszystkim proof of concept. Trzech uczestników to zdecydowanie za mało, aby stwierdzić, że identyczny system będzie działał równie skutecznie u każdej osoby z ALS, po udarze czy z innym typem paraliżu.
W dodatku zakres rozpoznawanych zachowań był nadal niewielki. Najbardziej rozbudowany eksperyment obejmował dziesięć gestów i dziesięć fraz. Codzienna komunikacja wymaga oczywiście niemal nieograniczonego słownika i ogromnej liczby subtelnych ruchów.
Wyniki pokazują jednak podstawową możliwość techniczną: jeden implant może dostarczyć sygnał wystarczający do równoległego dekodowania kilku rodzajów intencji ruchowych.
Kolejne badania będą musiały sprawdzić, jak system działa przy znacznie większym słownictwie, spontanicznej rozmowie, nowych gestach oraz u większej grupy uczestników. Ważna będzie również możliwość adaptowania modelu do zmieniających się sygnałów mózgowych bez konieczności ciągłego powtarzania długich sesji treningowych.
Interfejsy mózg–komputer coraz szybciej wychodzą poza pojedyncze funkcje
Rozwój BCI w ostatnich latach wyraźnie przyspieszył. Poszczególne systemy pozwalają już osobom z paraliżem generować mowę, pisać tekst, sterować kursorem, poruszać ramieniem robota czy animować cyfrowe twarze.
Nowe badanie UCSF pokazuje kolejny etap: zamiast tworzyć oddzielne urządzenie do każdego zadania, można zacząć budować wielofunkcyjne neuroprotezy obsługujące kilka elementów ludzkiej komunikacji naraz. Nature opisuje właśnie ten aspekt jako jeden z najważniejszych elementów pracy.
W praktyce jest to zbliżone do ewolucji innych technologii. Pierwsze komputery osobiste wykonywały pojedyncze zadania. Współczesne urządzenia obsługują równolegle dziesiątki procesów. BCI może przechodzić podobną drogę — od prostego przełącznika lub sterowania kursorem do interfejsu kontrolującego kilka cyfrowych reprezentacji ciała.
Różnica polega oczywiście na skali trudności. Każda dodatkowa funkcja wymaga odróżnienia kolejnych wzorców aktywności mózgowej oraz utrzymania wysokiej dokładności, gdy użytkownik wykonuje kilka działań jednocześnie.
Komputer nie zastępuje mózgu. Tłumaczy jego sygnały na cyfrową komunikację
Warto również precyzyjnie opisać rolę sztucznej inteligencji. Model AI nie generuje dowolnej odpowiedzi za użytkownika i nie decyduje, co powinien powiedzieć jego awatar.
Algorytm analizuje sygnały z elektrod i próbuje przypisać je do zamierzonej wypowiedzi albo gestu, których wzorców nauczył się wcześniej. Dopiero później cyfrowa reprezentacja wykonuje odpowiednią akcję.
Ma to ogromne znaczenie etyczne. Im bardziej zaawansowane stają się neuroprotezy komunikacyjne, tym ważniejsze będzie jasne rozróżnienie pomiędzy tym, co rzeczywiście pochodzi od użytkownika, a tym, co zostało uzupełnione lub przewidziane przez model.
W obecnym eksperymencie słownik był ograniczony i kontrolowany, dzięki czemu można było bardzo dokładnie mierzyć trafność systemu. Przyszłe BCI pozwalające na swobodną rozmowę będą musiały poradzić sobie nie tylko z większą liczbą możliwości, ale także z ryzykiem błędnego przypisania intencji użytkownika.
Podsumowanie
Badacze z UCSF pokazali pierwszy interfejs mózg–komputer, który z jednego implantu potrafi jednocześnie dekodować mowę i gesty u osób z paraliżem. System rejestruje aktywność kory sensomotorycznej i przekłada ją na wypowiedzi oraz ruchy pełnopostaciowego wirtualnego awatara.
Kluczowym odkryciem okazało się to, że aktywność mózgu podczas jednoczesnego mówienia i gestykulowania nie jest prostą sumą sygnałów rejestrowanych podczas obu czynności osobno. Dopiero trening modeli również na zachowaniach wykonywanych równocześnie pozwolił utrzymywać wysoką skuteczność w różnych kontekstach.
To nadal wczesne badanie na niewielkiej grupie uczestników, a obecny system wymaga przewodowego połączenia z zewnętrzną aparaturą. Kolejnym krokiem będzie jednak w pełni wszczepialna i bezprzewodowa wersja neuroprotezy.
Znaczenie pracy wykracza więc poza kolejną poprawę szybkości dekodowania słów. BCI zaczyna przywracać nie tylko to, co człowiek chce powiedzieć, ale także część sposobu, w jaki naturalnie się komunikuje.
Źródła
- National Institutes of Health – Neuroprosthesis for paralysis enables simultaneous speech and body language, 14 września 2026 r.
- Samantha C. Brosler, Jessie R. Liu, Alexander B. Silva et al., Simultaneous speech and gesture decoding for multimodal communication in paralysis, Nature Neuroscience, 2026, DOI: 10.1038/s41593-026-02446-2.
- Miryam Naddaf, ‘Multifunctional’ brain implant translates speech and gestures in real time, Nature, 14 września 2026 r.
Dziękujemy za przeczytanie artykułu na Techoteka.pl.
Publikujemy codziennie informacje o sztucznej inteligencji, nowych technologiach, IT oraz rozwoju agentów AI.
Obserwuj nas na Facebooku, aby nie przegapić kolejnych artykułów.