
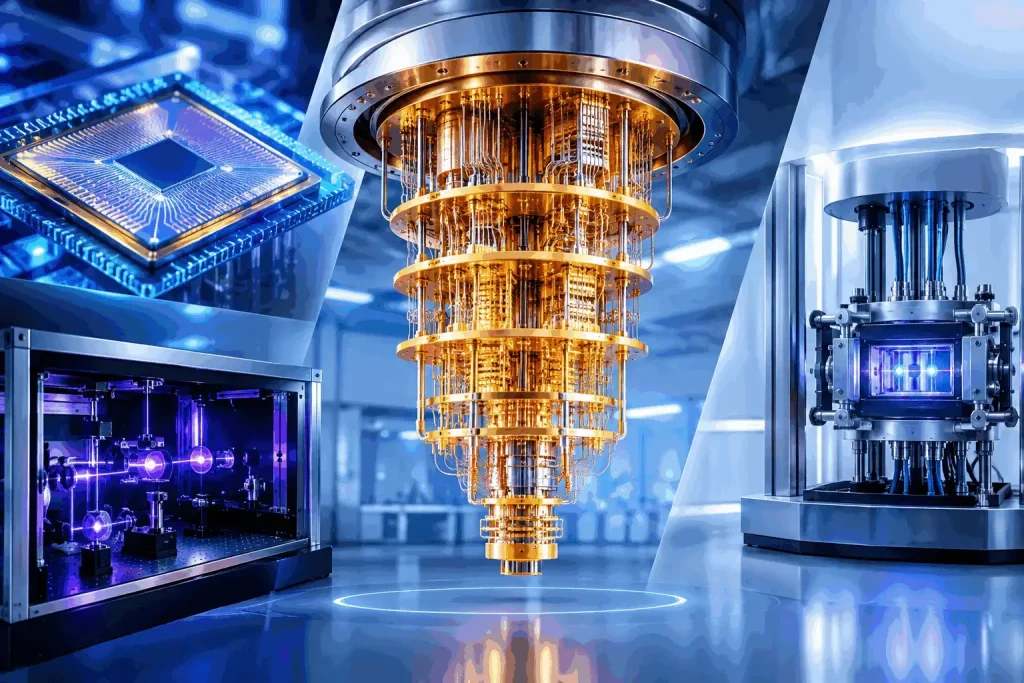
Jak działa komputer kwantowy? Najprościej mówiąc, jest to maszyna, która wykonuje obliczenia wykorzystując prawa mechaniki kwantowej, czyli fizyki opisującej zachowanie bardzo małych obiektów, takich jak atomy, elektrony czy fotony. Zwykły komputer przechowuje i przetwarza informacje za pomocą bitów mających wartość 0 albo 1, natomiast komputer kwantowy wykorzystuje kubity, których stan można przygotować jako odpowiednią kombinację 0 i 1. To właśnie ta różnica otwiera drogę do zupełnie innego sposobu wykonywania niektórych obliczeń.
Nie oznacza to jednak, że komputer kwantowy jest po prostu niewiarygodnie szybkim odpowiednikiem laptopa czy superkomputera. Jego przewaga może pojawiać się tylko w określonych klasach problemów, dla których potrafimy stworzyć odpowiedni algorytm kwantowy. Kluczowe znaczenie mają przy tym trzy zjawiska: superpozycja, splątanie oraz interferencja, dzięki którym algorytm może manipulować prawdopodobieństwami wyników w sposób niedostępny dla klasycznej elektroniki. NIST podkreśla jednocześnie, że popularne stwierdzenie, jakoby komputer kwantowy po prostu „sprawdzał wszystkie rozwiązania jednocześnie”, jest zbyt dużym uproszczeniem.
W tym artykule wyjaśniamy prostymi słowami, jak działa komputer kwantowy, czym kubit różni się od zwykłego bitu, czym są superpozycja, splątanie i interferencja, w jaki sposób wykonuje się program kwantowy oraz dlaczego zbudowanie dużego i niezawodnego komputera kwantowego jest tak trudne.
Najważniejsze informacje:
- Komputer kwantowy nie wykorzystuje zwykłych bitów, lecz kubity, których stan może być kombinacją wartości odpowiadających 0 i 1.
- Przewaga obliczeń kwantowych wynika nie z samej superpozycji, lecz ze współdziałania superpozycji, splątania i interferencji.
- Algorytm kwantowy manipuluje stanem kubitów za pomocą bramek kwantowych, podobnie jak klasyczny komputer wykonuje operacje logiczne na bitach.
- Po zakończeniu obliczeń kubity są mierzone, a użytkownik otrzymuje zwykły wynik zapisany w postaci zer i jedynek.
- Komputer kwantowy nie jest szybszy od zwykłego komputera we wszystkich zadaniach i nie ma zastępować laptopów, smartfonów czy klasycznych serwerów.
- Jednym z największych problemów pozostają błędy i dekoherencja, dlatego rozwój korekcji błędów kwantowych jest kluczowy dla budowy dużych, praktycznych systemów.
- Potencjalne zastosowania obejmują między innymi symulowanie układów kwantowych, badania materiałów i cząsteczek, wybrane problemy matematyczne oraz część zadań optymalizacyjnych.
Jak działa komputer kwantowy? Najprostsze wyjaśnienie
Aby zrozumieć, jak działa komputer kwantowy, najlepiej zacząć od zwykłego komputera. Laptop, smartfon czy serwer wykonuje obliczenia, manipulując ogromną liczbą bitów. Każdy bit przyjmuje w konkretnej chwili jedną z dwóch wartości: 0 albo 1. Procesor wykonuje na nich operacje logiczne, a z olbrzymiej liczby bardzo prostych działań powstają programy, gry, strony internetowe, modele sztucznej inteligencji i wszystkie inne cyfrowe usługi.
Komputer kwantowy korzysta z innego rodzaju jednostki informacji, czyli kubitu. Jego stan nie musi odpowiadać wyłącznie klasycznemu 0 albo 1, ponieważ może być przygotowany jako superpozycja obu tych stanów. Kiedy łączymy kilka kubitów, możemy opisywać jeden wspólny stan kwantowy obejmujący wiele możliwych konfiguracji. Dwa kubity mogą reprezentować kombinacje odpowiadające 00, 01, 10 i 11, a wraz ze wzrostem liczby kubitów liczba możliwych składników takiego stanu rośnie wykładniczo.
Sama możliwość utworzenia wielu składników stanu kwantowego nie daje jeszcze użytecznego wyniku. Algorytm musi wykonywać na kubitach odpowiednio zaprojektowane operacje, aby niektóre możliwości zostały wzmocnione, a inne osłabione przez zjawisko interferencji. Dopiero na końcu następuje pomiar, po którym otrzymujemy klasyczną informację możliwą do odczytania przez zwykły komputer.
Można więc powiedzieć, że komputer kwantowy nie tyle „liczy szybciej”, ile organizuje obliczenie w zupełnie inny sposób, wykorzystując matematyczne właściwości mechaniki kwantowej.
Czym różni się bit od kubitu?
W klasycznym komputerze podstawową jednostką informacji jest bit, który można porównać do przełącznika znajdującego się w jednym z dwóch położeń. W uproszczeniu stan wyłączony odpowiada 0, a włączony 1. Osiem bitów pozwala utworzyć 256 różnych kombinacji, ale w danym momencie klasyczny rejestr ośmiobitowy reprezentuje jedną konkretną kombinację, na przykład 01101001.
Kubit, czyli quantum bit, podlega innym zasadom. Może znajdować się w stanie odpowiadającym 0, w stanie odpowiadającym 1 albo w superpozycji tych dwóch stanów, przy czym nie jest to po prostu sytuacja, w której „nie wiemy, czy mamy zero, czy jedynkę”. Stan kubitu zawiera amplitudy kwantowe określające późniejsze prawdopodobieństwa wyników pomiaru, a dodatkowo amplitudy posiadają fazę, która okazuje się niezwykle ważna podczas interferencji.
Przy dwóch kubitach wspólny stan może obejmować cztery możliwości, przy trzech osiem, przy czterech szesnaście, natomiast przy liczbie nn kubitów przestrzeń stanów obejmuje 2n2^n składników. To właśnie ten wykładniczy wzrost często pojawia się w popularnych opisach komputerów kwantowych.
Trzeba jednak zachować ostrożność przy interpretacji tej własności. Z komputera kwantowego nie można po prostu odczytać wszystkich 2n2^n wartości, ponieważ pomiar zwraca ograniczoną ilość klasycznej informacji. Siła algorytmu polega na takim przekształcaniu całego stanu przed pomiarem, aby interesująca odpowiedź stała się bardziej prawdopodobna. NIST zwraca uwagę, że właśnie ten aspekt jest często pomijany w uproszczonych opisach technologii.
Co to jest superpozycja kwantowa?
Superpozycja jest jednym z najważniejszych pojęć potrzebnych do zrozumienia działania komputera kwantowego, ale bardzo łatwo przedstawić ją w sposób prowadzący do błędnych wniosków. W dużym uproszczeniu pozwala ona przygotować kubit jako kombinację stanów 0 oraz 1, zamiast ograniczać go do jednej z tych dwóch wartości przed rozpoczęciem obliczeń.
Wyobraźmy sobie klasyczną monetę leżącą na stole. Po sprawdzeniu widzimy orła albo reszkę, dlatego intuicyjnie chciałoby się przedstawić kubit jako monetę wirującą w powietrzu. Analogia pomaga uchwycić pomysł, że wynik nie jest jeszcze ustalony, ale nie opisuje fizyki dokładnie, ponieważ stan kwantowy zawiera nie tylko zwykłe prawdopodobieństwa, lecz także amplitudy i fazy, które później mogą ze sobą interferować.
Microsoft wyjaśnia superpozycję jako możliwość występowania kubitu w kombinacji dwóch stanów bazowych, natomiast NIST zaznacza, że po wykonaniu pomiaru otrzymujemy konkretny wynik zgodny z prawdopodobieństwem wynikającym z przygotowanego stanu.
Superpozycja pozwala algorytmowi operować na bogatszym stanie matematycznym niż pojedynczy ciąg klasycznych bitów. Nie oznacza jednak, że komputer kwantowy automatycznie otrzymuje odpowiedź na milion problemów jednocześnie. Dopiero odpowiednia sekwencja bramek, splątanie i interferencja sprawiają, że możliwości zapisane w stanie kubitów mogą zostać wykorzystane do uzyskania przewagi w konkretnym algorytmie.
Co to jest splątanie kwantowe?
Splątanie kwantowe pojawia się wtedy, gdy stan dwóch lub większej liczby kubitów zostaje połączony w taki sposób, że nie można już w pełni opisać każdego z nich oddzielnie. Zamiast mówić o niezależnym stanie pierwszego i drugiego kubitu, musimy opisywać wspólny stan całego układu. Microsoft określa splątanie jako kwantową korelację, która nie ma bezpośredniego odpowiednika w klasycznych systemach informacyjnych.
Przykładowo można przygotować dwa kubity w stanie, w którym pomiar zawsze daje 00 albo 11, przy czym przed pomiarem nie możemy przypisać każdemu kubitowi niezależnej, ustalonej wartości. Wyniki są ze sobą skorelowane, ponieważ kubity tworzą jeden wspólny stan kwantowy.
Splątanie jest niezwykle istotne, ponieważ umożliwia tworzenie zależności obejmujących wiele kubitów i pozwala algorytmom operować na całych strukturach informacji. W połączeniu z superpozycją oraz interferencją umożliwia projektowanie obliczeń, których klasyczny odpowiednik może wymagać zupełnie innej ilości zasobów.
Nie należy przy tym utożsamiać splątania z możliwością natychmiastowego przesyłania dowolnych wiadomości na dowolną odległość. Korelacje pomiędzy wynikami pomiarów są realnym i potwierdzonym zjawiskiem kwantowym, ale nie tworzą prostego „kwantowego komunikatora”, który pozwalałby ominąć ograniczenia dotyczące przesyłania informacji.
Dlaczego interferencja jest tak ważna?
Superpozycja i splątanie zwykle przyciągają najwięcej uwagi, ale z punktu widzenia działania algorytmu równie ważna jest interferencja kwantowa. To dzięki niej można zwiększać prawdopodobieństwo otrzymania pożądanego wyniku i zmniejszać prawdopodobieństwo rezultatów, które nie prowadzą do rozwiązania.
Najłatwiej wyobrazić sobie to na przykładzie fal na wodzie. Gdy dwie fale spotkają się w odpowiedni sposób, ich wysokości mogą się zsumować, tworząc większą falę. Jeżeli natomiast grzbiet jednej spotka się z doliną drugiej, mogą się częściowo albo całkowicie wygasić. W mechanice kwantowej analogiczną rolę odgrywają amplitudy prawdopodobieństwa, które mogą interferować konstruktywnie lub destruktywnie.
IBM określa interferencję jako jeden z podstawowych mechanizmów napędzających obliczenia kwantowe. Algorytm przygotowuje superpozycję, wykonuje serię operacji zmieniających amplitudy i fazy, a następnie wykorzystuje interferencję do wzmacniania właściwych wyników oraz wygaszania części błędnych możliwości.
To właśnie dlatego zdanie „komputer kwantowy sprawdza wszystkie odpowiedzi naraz” jest niewystarczające. Gdyby wystarczyło utworzyć superpozycję, a następnie wykonać pomiar, zwykle otrzymalibyśmy losowy rezultat. Prawdziwa sztuka polega na skonstruowaniu algorytmu, który przed pomiarem odpowiednio przekształci cały stan kwantowy.
Co robią bramki kwantowe?
Zwykły procesor wykorzystuje bramki logiczne wykonujące elementarne operacje na bitach, natomiast komputer kwantowy korzysta z bramek kwantowych, które zmieniają stan pojedynczych kubitów albo grup kubitów. Sekwencja takich bramek tworzy obwód kwantowy, będący odpowiednikiem programu wykonywanego przez procesor kwantowy.
Jedną z często używanych operacji jest bramka Hadamarda, która może przygotować kubit znajdujący się początkowo w stanie 0 w odpowiedniej superpozycji stanów 0 i 1. Innym przykładem jest CNOT, czyli sterowana bramka NOT, która działa na dwóch kubitach i może być użyta do tworzenia stanów splątanych. Microsoft pokazuje właśnie połączenie bramki Hadamarda z CNOT jako podstawowy przykład przygotowania splątanej pary kubitów.
W bardziej skomplikowanym algorytmie występują setki, tysiące albo znacznie większa liczba operacji dobranych w taki sposób, aby zmienić amplitudy i relacje fazowe całego stanu. Każda bramka odpowiada określonemu przekształceniu matematycznemu i musi zostać fizycznie zrealizowana przez sprzęt.
Sposób realizacji zależy od technologii kubitów. W jednych urządzeniach wykorzystuje się impulsy mikrofalowe, w innych lasery, natomiast jeszcze inne rozwiązania korzystają z napięć i pól elektromagnetycznych.
Komputer kwantowy – przykłady działających maszyn
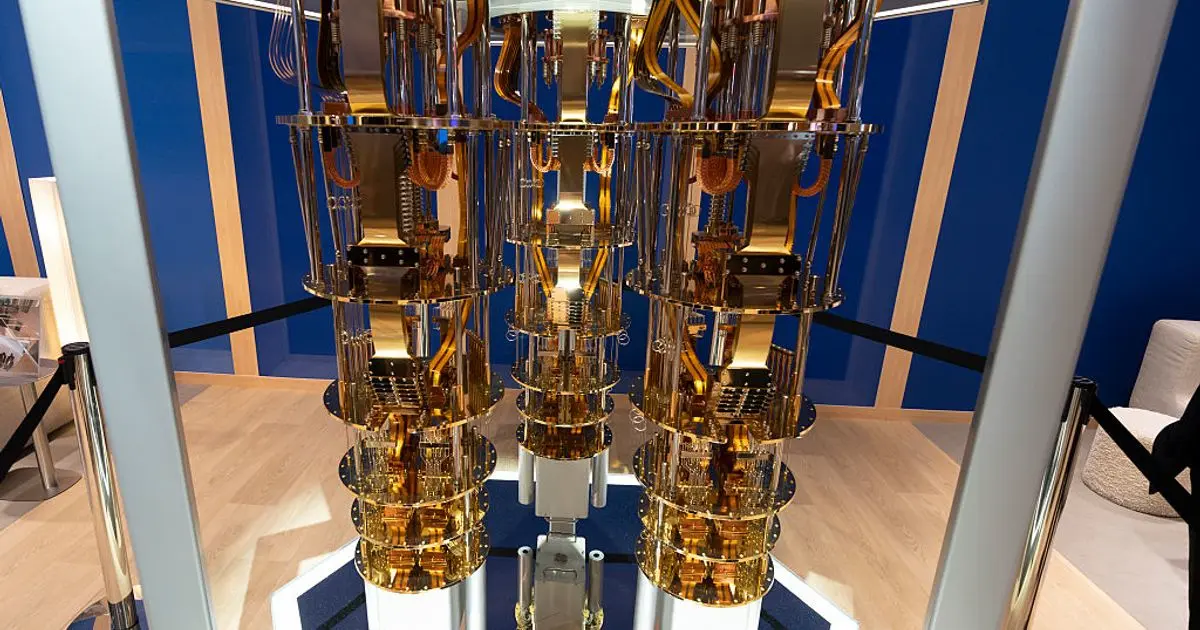
Przykłady komputerów kwantowych pokazują, że nie istnieje dziś jedna dominująca konstrukcja takiej maszyny. Poszczególne firmy wykorzystują różne technologie kubitów, a systemy różnią się sposobem chłodzenia, sterowania i wykonywania obliczeń. IBM rozwija komputery oparte na kubitach nadprzewodzących, w tym platformę IBM Quantum System Two, współpracującą z procesorami Heron i Nighthawk. Obecne układy Heron mają 133 lub 156 programowalnych kubitów, natomiast Nighthawk wykorzystuje 120 kubitów i architekturę zaprojektowaną z myślą o wykonywaniu coraz bardziej złożonych obwodów.
Innym przykładem jest Google Willow, czyli nadprzewodzący procesor kwantowy wyposażony w 105 kubitów. Google wykorzystuje go między innymi do badań nad korekcją błędów kwantowych. Firma wykazała, że przy zwiększaniu rozmiaru kodowanych struktur można obniżać poziom błędów, co jest jednym z kluczowych warunków budowy przyszłych komputerów kwantowych odpornych na zakłócenia.
Nie wszystkie systemy opierają się jednak na nadprzewodnikach. Quantinuum System Model H2 wykorzystuje uwięzione jony i oferuje 56 w pełni połączonych kubitów, natomiast nowszy system Helios również bazuje na architekturze jonowej. Z kolei IonQ rozwija uniwersalne komputery kwantowe oparte na technologii uwięzionych jonów.
Jeszcze inną kategorię reprezentują maszyny D-Wave, wykorzystujące tzw. wyżarzanie kwantowe. Nie są one bezpośrednim odpowiednikiem uniwersalnych komputerów bramkowych IBM czy Google, ponieważ zostały zaprojektowane głównie do rozwiązywania problemów optymalizacyjnych i próbkowania poprzez poszukiwanie stanów o możliwie niskiej energii. Te przykłady dobrze pokazują, że określenie „komputer kwantowy” obejmuje dziś kilka różnych podejść technologicznych, które mogą w przyszłości znaleźć zastosowanie w odmiennych typach problemów.
Jak wygląda program wykonywany przez komputer kwantowy?
Program kwantowy zaczyna się zwykle od przygotowania kubitów w znanym stanie początkowym, na przykład 0000. Następnie wykonywana jest sekwencja bramek kwantowych, które tworzą superpozycje, wprowadzają splątanie oraz zmieniają amplitudy i fazy odpowiadające poszczególnym możliwym wynikom.
W przeciwieństwie do klasycznego programu nie obserwujemy po każdej operacji pełnego stanu wszystkich kubitów. Pomiar ingeruje bowiem w stan kwantowy, dlatego nie można swobodnie zaglądać do środka obliczenia tak, jak debugger może odczytać zawartość klasycznego rejestru procesora.
Po wykonaniu całego obwodu następuje pomiar wybranych kubitów. Wynikiem jest zwykły ciąg zer i jedynek, na przykład 0101. Ponieważ mechanika kwantowa ma charakter probabilistyczny, ten sam obwód uruchamia się często wiele razy, a następnie analizuje rozkład uzyskanych wyników. Dzięki temu można określić, które odpowiedzi występują najczęściej i czy algorytm rzeczywiście zwiększył prawdopodobieństwo właściwego rozwiązania.
W praktyce procesor kwantowy zwykle współpracuje więc z klasycznym komputerem. Klasyczny system przygotowuje zadanie, steruje eksperymentem, odbiera wyniki pomiarów i wykonuje dalszą analizę, podczas gdy układ kwantowy realizuje tę część obliczenia, dla której zaprojektowano operacje wykorzystujące mechanikę kwantową.
Dlaczego wynik trzeba mierzyć?
Jedną z najbardziej nieintuicyjnych cech komputera kwantowego jest to, że bogaty stan utworzony przez wiele kubitów nie może zostać w całości skopiowany do zwykłej pamięci i wyświetlony użytkownikowi. Gdy wykonujemy pomiar, otrzymujemy określony klasyczny wynik zgodnie z rozkładem prawdopodobieństwa utworzonym przez wcześniejsze operacje.
NIST zwraca uwagę, że właśnie ograniczenie związane z odczytem jest jednym z powodów, dla których popularne wyobrażenie o „wykonywaniu wszystkich obliczeń jednocześnie” prowadzi do nieporozumień. Nawet jeśli stan nn kubitów zawiera amplitudy dla ogromnej liczby konfiguracji, pojedynczy pomiar nie pozwala wypisać wszystkich tych wartości.
Dlatego dobrze zaprojektowany algorytm kwantowy musi wykonać większość pracy przed pomiarem. Operacje są układane tak, aby wykorzystując interferencję zwiększyć prawdopodobieństwo wartości niosących przydatną informację. Następnie obwód wykonuje się wielokrotnie, aby zebrać próbki i oszacować wynik z odpowiednią dokładnością.
To zasadniczo inny model obliczeń niż klasyczne programowanie, w którym możemy w każdej chwili zapisać zawartość pamięci, przesłać ją dalej i wykonać na niej kolejne deterministyczne operacje. W komputerze kwantowym sam sposób odczytu informacji jest częścią projektu algorytmu.
Czy komputer kwantowy sprawdza wszystkie możliwości naraz?
To jeden z najczęściej powtarzanych opisów komputerów kwantowych, ale potraktowany dosłownie jest błędny. Superpozycja rzeczywiście pozwala reprezentować kombinację wielu stanów, dlatego można powiedzieć, że pewne operacje matematyczne oddziałują jednocześnie na cały taki stan. Nie oznacza to jednak, że komputer tworzy listę wszystkich rozwiązań, analizuje każde z nich osobno, a następnie po prostu wybiera najlepsze.
Gdybyśmy przygotowali równomierną superpozycję wszystkich możliwości i od razu dokonali pomiaru, otrzymalibyśmy jedną z nich zgodnie z odpowiednimi prawdopodobieństwami. Nie dostalibyśmy automatycznie informacji wskazującej, która odpowiedź jest prawidłowa.
NIST podaje to jako istotne ograniczenie popularnej metafory „kwantowej równoległości”. Algorytm musi zostać zaprojektowany tak, aby przekształcenia i interferencja wydobyły globalną właściwość interesującego nas problemu, a następnie zwiększyły szansę uzyskania użytecznego wyniku podczas pomiaru.
Lepszym uproszczeniem jest więc stwierdzenie, że komputer kwantowy manipuluje rozkładem możliwości, a następnie wykorzystuje prawa mechaniki kwantowej do wydobywania określonych informacji. Taki opis może nie brzmieć równie spektakularnie jak „sprawdzanie wszystkiego naraz”, ale znacznie lepiej odpowiada rzeczywistemu mechanizmowi działania.
Z czego fizycznie zbudowany jest komputer kwantowy?
Określenie „komputer kwantowy” nie oznacza jednej konkretnej konstrukcji, ponieważ kubit można zrealizować na wiele sposobów. Najważniejsze jest stworzenie układu fizycznego posiadającego dwa odpowiednio kontrolowane stany, które można przygotowywać, łączyć, przekształcać i mierzyć zgodnie z zasadami mechaniki kwantowej.
Jedna z najpopularniejszych technologii wykorzystuje kubity nadprzewodzące, czyli mikroskopijne obwody elektryczne pracujące w niezwykle niskich temperaturach. Inne systemy wykorzystują uwięzione jony, w których informacja jest przechowywana w stanach atomów kontrolowanych za pomocą pól elektromagnetycznych i laserów. Istnieją również podejścia fotoniczne, neutralne atomy, kubity spinowe oraz badania nad innymi sposobami fizycznej realizacji informacji kwantowej. Microsoft wymienia między innymi kubity nadprzewodzące, uwięzione jony oraz podejścia topologiczne.
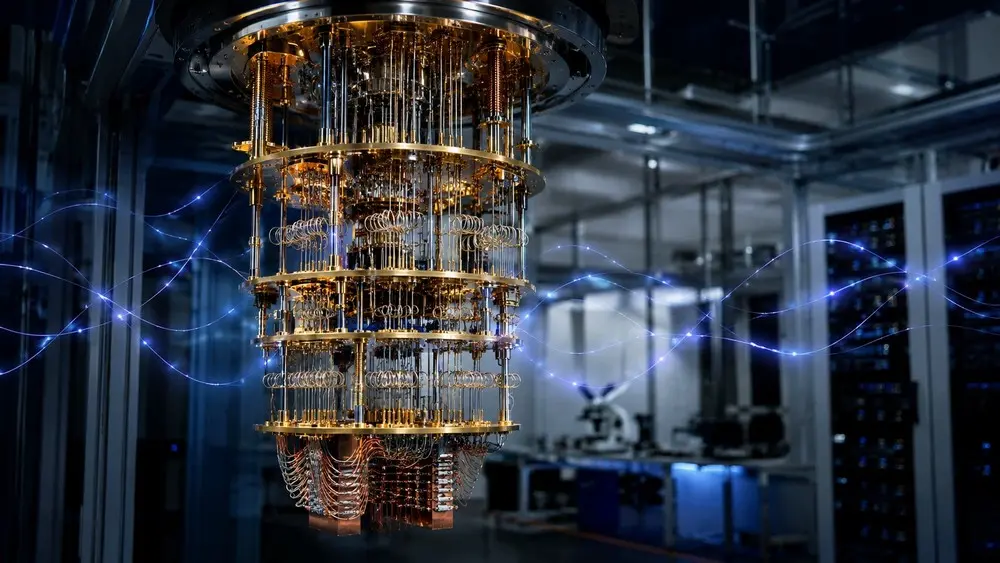
Wokół samego procesora potrzebna jest duża infrastruktura sterująca. Obejmuje ona elektronikę, generatory impulsów, układy odczytu, systemy chłodzenia albo próżni, a także klasyczne komputery analizujące wyniki.
Dlatego zdjęcie kompletnej instalacji kwantowej może wyglądać znacznie bardziej imponująco niż sam układ zawierający kubity. Duża część widocznej aparatury służy właśnie do stworzenia środowiska, w którym wyjątkowo delikatne stany kwantowe mogą być kontrolowane z odpowiednią dokładnością.
Dlaczego komputery kwantowe wymagają tak trudnych warunków?
Największym wrogiem obliczeń kwantowych jest otoczenie. Kubit musi zachować kontrolowany stan wystarczająco długo, aby można było wykonać na nim cały potrzebny zestaw operacji. Tymczasem przypadkowe oddziaływanie z ciepłem, promieniowaniem elektromagnetycznym, drganiami albo innymi elementami środowiska może zaburzyć stan kwantowy.
Proces utraty właściwości potrzebnych do obliczenia nazywamy dekoherencją. IBM opisuje ją jako przejście układu ze stanu kwantowego do stanu, w którym pożądane właściwości kwantowe zostają utracone, przy czym może zostać wywołana zarówno celowym pomiarem, jak i niekontrolowanym oddziaływaniem środowiska.
W przypadku nadprzewodzących kubitów rozwiązaniem jest umieszczenie procesora w lodówce rozcieńczalnikowej utrzymującej temperaturę bardzo bliską zeru absolutnemu. Chłodzenie ogranicza zakłócenia cieplne i pozwala materiałom pracować w stanie nadprzewodzącym. W systemach opartych na uwięzionych jonach stosuje się natomiast bardzo dokładnie kontrolowaną próżnię i układy laserowe.
Problem jest paradoksalny, ponieważ kubity trzeba jednocześnie doskonale izolować od niepożądanego świata zewnętrznego oraz precyzyjnie kontrolować, aby wykonywać na nich operacje i odczytywać wyniki. Im większy system, tym trudniej utrzymać tę równowagę.
Dlaczego komputery kwantowe popełniają błędy?
Klasyczne układy cyfrowe są niezwykle odporne na drobne zakłócenia, ponieważ wartość bitu można jednoznacznie zakodować jako dwa wyraźnie rozdzielone stany elektryczne. W przypadku kubitów musimy zachować bardzo delikatne amplitudy, fazy i korelacje kwantowe, dlatego nawet niewielkie zaburzenie może obniżyć dokładność wykonywanej operacji.
Błędy mogą pojawiać się podczas przygotowywania kubitów, wykonywania bramek, utrzymywania stanu, splątywania oraz końcowego pomiaru. W efekcie im dłuższy i bardziej złożony obwód kwantowy, tym większe znaczenie ma niezawodność każdego elementu.
NIST wskazuje dekoherencję i błędy jako jedne z podstawowych barier na drodze do dużych komputerów kwantowych, ponieważ użyteczne maszyny muszą utrzymywać kontrolę nad wieloma wzajemnie powiązanymi kubitami podczas całego obliczenia.
Rozwiązaniem ma być kwantowa korekcja błędów, która nie polega na skopiowaniu kubitu kilka razy tak jak w prostym systemie klasycznym. Informacja jednego stabilnego kubitu logicznego może zostać rozłożona na większą liczbę fizycznych kubitów w taki sposób, aby wykrywać i korygować błędy bez bezpośredniego odczytywania chronionej informacji. Właśnie dlatego liczba fizycznych kubitów nie jest równoznaczna z liczbą wysokiej jakości kubitów logicznych dostępnych dla przyszłych algorytmów.
Co oznacza kwantowa korekcja błędów?
Korekcja błędów kwantowych jest próbą rozwiązania jednego z największych problemów tej technologii, czyli wyjątkowej podatności kubitów na zakłócenia. Zamiast ufać pojedynczemu fizycznemu kubitowi, informację koduje się w większej strukturze obejmującej wiele kubitów fizycznych.
System wykonuje następnie specjalne pomiary pozwalające wykryć, że w kodowanej informacji pojawił się błąd, ale bez bezpośredniego odczytywania samego stanu logicznego. Jest to niezbędne, ponieważ zwykłe zmierzenie kubitu zniszczyłoby superpozycję, którą próbujemy chronić.
W praktyce oznacza to, że przyszły komputer kwantowy wykonujący długie i niezawodne algorytmy może potrzebować znacznie większej liczby fizycznych kubitów niż wynosi liczba kubitów logicznych używanych przez program. Wymagany narzut zależy od jakości sprzętu, rodzaju kodu korekcji błędów i wymaganej niezawodności.
To także wyjaśnia, dlaczego sama informacja o liczbie kubitów w procesorze niewiele mówi o jego praktycznej mocy. System posiadający większą liczbę kubitów, ale charakteryzujący się wysokim poziomem błędów i słabą łącznością, nie musi być bardziej użyteczny od mniejszego, lepiej kontrolowanego procesora. W rozwoju komputerów kwantowych coraz większe znaczenie mają więc jakość bramek, czas koherencji, architektura połączeń oraz możliwość skutecznego tworzenia kubitów logicznych.
Do czego komputer kwantowy może być naprawdę przydatny?
Najbardziej naturalnym zastosowaniem komputera kwantowego jest symulowanie innych układów kwantowych. Cząsteczki, materiały i reakcje chemiczne same podlegają mechanice kwantowej, a ich dokładne odwzorowanie na klasycznym komputerze może stawać się niezwykle trudne wraz ze wzrostem wielkości badanego układu. Microsoft wskazuje materiały, chemię, energię i inne dziedziny nauki jako jedne z obszarów potencjalnych zastosowań tej technologii.
Jeżeli uda się zbudować wystarczająco duże i niezawodne maszyny, obliczenia kwantowe mogą pomagać w analizowaniu właściwości nowych materiałów, katalizatorów, cząsteczek czy procesów chemicznych. Nie oznacza to automatycznie, że komputer kwantowy sam „wynajdzie lek”, lecz może stać się jednym z narzędzi używanych przez badaczy do symulowania problemów, które trudno wiernie odwzorować metodami klasycznymi.
Innym obszarem są wyspecjalizowane algorytmy matematyczne. Najbardziej znanym przykładem jest algorytm Shora przeznaczony między innymi do faktoryzacji dużych liczb. Istnieje również algorytm Grovera, który zapewnia kwadratowe przyspieszenie dla pewnego rodzaju problemu wyszukiwania.
Badane są ponadto zastosowania w optymalizacji, uczeniu maszynowym oraz analizie złożonych systemów, chociaż dla wielu z tych obszarów trzeba jeszcze wykazać praktyczną przewagę nad coraz lepszymi metodami klasycznymi.
Czy komputer kwantowy zastąpi zwykły komputer?
Komputer kwantowy nie jest projektowany po to, aby zastąpić procesor znajdujący się w laptopie, smartfonie albo konsoli. Klasyczne komputery są niezwykle wydajne w ogromnej liczbie codziennych zadań, a ich produkcja, oprogramowanie i infrastruktura zostały rozwinięte przez dziesięciolecia.
Uruchamianie przeglądarki, edytora tekstu, systemu operacyjnego, serwera WWW czy większości gier na komputerze kwantowym nie dawałoby naturalnej przewagi. NIST w swoim wyjaśnieniu technologii wskazuje wprost, że komputery kwantowe nie mają zastąpić klasycznych maszyn, lecz mogą z nimi współpracować przy problemach, które są wyjątkowo trudne dla tradycyjnych systemów.
Bardziej prawdopodobny model przypomina więc dzisiejsze wykorzystanie wyspecjalizowanych akceleratorów. Procesor CPU realizuje zadania ogólne, GPU przejmuje wybrane obliczenia silnie równoległe, natomiast procesor kwantowy może w przyszłości wykonywać tę część problemu, dla której istnieje korzystny algorytm kwantowy.
Użytkownik nie musi przy tym posiadać komputera kwantowego na biurku. Już obecnie dostęp do części urządzeń odbywa się przez chmurę, a program jest wysyłany do odległego procesora kwantowego podobnie jak zadanie przekazywane do klasycznego centrum danych. W przyszłości taki model może pozostać znacznie bardziej praktyczny niż budowanie domowych komputerów kwantowych.
Czy komputer kwantowy jest szybszy od superkomputera?
Pytanie o to, czy komputer kwantowy jest „szybszy”, wymaga wskazania konkretnego zadania. Nie istnieje jedna uniwersalna prędkość komputera, która pozwalałaby stwierdzić, że procesor kwantowy jest zawsze szybszy od klasycznego superkomputera.
W przypadku większości codziennych obliczeń klasyczny komputer pozostaje zdecydowanie bardziej praktyczny. Zaletą algorytmów kwantowych jest możliwość uzyskania korzystniejszej złożoności dla określonych problemów, co oznacza, że wraz ze wzrostem rozmiaru zadania liczba potrzebnych operacji może rosnąć wolniej niż w najlepszej znanej metodzie klasycznej.
Istotna jest właśnie skala problemu. Dla niewielkiego zadania narzut związany z obsługą urządzenia kwantowego może całkowicie zniwelować teoretyczną korzyść, natomiast przy odpowiednio dużym problemie różnica wynikająca z lepszego algorytmu może stać się dominująca.
Dlatego sensowniej pytać, czy istnieje przewaga kwantowa dla konkretnego problemu, niż porównywać komputer kwantowy i superkomputer tak jak dwa procesory mierzone jednym benchmarkiem. Microsoft również opisuje komputery kwantowe jako systemy przeznaczone do problemów, w których wraz ze wzrostem rozmiaru zadania klasyczne metody napotykają poważne ograniczenia.
Czy komputer kwantowy może złamać szyfrowanie?
Jednym z najbardziej znanych potencjalnych zastosowań obliczeń kwantowych jest wykorzystanie algorytmu Shora, który na wystarczająco dużym, odpornym na błędy komputerze kwantowym mógłby efektywnie rozwiązywać problemy matematyczne stanowiące podstawę bezpieczeństwa części współczesnej kryptografii klucza publicznego.
Nie oznacza to jednak, że działające obecnie komputery kwantowe mogą po prostu złamać zabezpieczenia banków, komunikatorów czy całego internetu. Zrealizowanie takiego ataku na praktycznie istotną skalę wymagałoby maszyny znacznie bardziej niezawodnej i skalowalnej niż urządzenia wykorzystywane obecnie do badań.
Ryzyko jest jednak traktowane poważnie na długo przed pojawieniem się takiej maszyny. W 2024 roku NIST opublikował trzy pierwsze finalne standardy kryptografii postkwantowej: FIPS 203, FIPS 204 i FIPS 205, zaprojektowane jako rozwiązania odporne na przyszłe ataki wykonywane przy użyciu komputerów kwantowych. Proces rozwijania zestawu algorytmów PQC jest nadal kontynuowany.
W praktyce wpływ komputerów kwantowych na bezpieczeństwo internetu rozpoczął się więc jeszcze przed powstaniem kryptograficznie użytecznej maszyny kwantowej. Organizacje stopniowo przygotowują migrację do nowych algorytmów właśnie dlatego, że wymiana infrastruktury kryptograficznej wymaga wielu lat.
Jak komputer kwantowy rozwiązuje problem krok po kroku?
Najprostszy schemat działania można przedstawić bez zagłębiania się w skomplikowaną matematykę. Najpierw klasyczny komputer przygotowuje zadanie oraz opis obwodu kwantowego, który ma zostać wykonany. Procesor kwantowy inicjalizuje następnie kubity w kontrolowanym stanie początkowym.
W kolejnym etapie bramki wprowadzają kubity w superpozycję i tworzą potrzebne zależności poprzez splątanie. Następne operacje zmieniają fazy i amplitudy składników wspólnego stanu w sposób określony przez algorytm. Interferencja sprawia, że część możliwych wyników zostaje wzmocniona, podczas gdy inne są stopniowo wygaszane.
Po zakończeniu obwodu wybrane kubity zostają zmierzone, a procesor zwraca klasyczny ciąg bitów. Ponieważ pojedyncze wykonanie może dawać probabilistyczny wynik, program uruchamia obwód wielokrotnie i zbiera statystykę rezultatów.
Na końcu klasyczny komputer interpretuje pomiary i przekształca je w odpowiedź na początkowe pytanie. W praktycznych systemach mamy więc do czynienia z hybrydą obliczeń klasycznych i kwantowych, a nie z całkowicie niezależną maszyną wykonującą od początku do końca wszystkie czynności potrzebne użytkownikowi.
Dlaczego komputer kwantowy jest tak trudny do zbudowania?
Trudność nie polega wyłącznie na stworzeniu pojedynczego kubitu. Naukowcy potrafią kontrolować układy kwantowe od dawna, natomiast znacznie większym wyzwaniem jest połączenie dużej liczby kubitów, wykonywanie na nich niezwykle precyzyjnych operacji i jednoczesne utrzymanie bardzo niskiego poziomu błędów.
Każdy dodatkowy element zwiększa złożoność sterowania, liczbę potrzebnych przewodów lub wiązek laserowych, wymagania dotyczące kalibracji oraz liczbę potencjalnych źródeł zakłóceń. Jednocześnie program potrzebuje wysokiej jakości operacji wykonywanych na pojedynczych kubitach oraz pomiędzy różnymi kubitami.
Do tego dochodzi kwantowa korekcja błędów, która zwiększa liczbę fizycznych elementów potrzebnych do reprezentowania użytecznej informacji logicznej. Zamiast więc po prostu zwiększać liczbę kubitów tak, jak zwiększa się liczbę tranzystorów w klasycznym procesorze, konstruktorzy muszą równocześnie poprawiać ich jakość i architekturę całego systemu.
NIST podkreśla, że kubity są wyjątkowo wrażliwe na pola elektryczne i magnetyczne, temperaturę oraz inne zakłócenia, a stworzenie dużego urządzenia wymaga utrzymania superpozycji i splątania wystarczająco długo, by wykonać przydatny algorytm.
Jak wytłumaczyć komputer kwantowy na prostym przykładzie?
Wyobraźmy sobie problem, w którym chcemy znaleźć określoną informację ukrytą w ogromnym zbiorze możliwości. Klasyczny komputer może wykorzystywać bardzo wydajne algorytmy, ale nadal operuje na konkretnych stanach bitów i wykonuje określoną sekwencję instrukcji.
Komputer kwantowy może przygotować stan będący kombinacją wielu możliwości, a następnie wykonywać operacje wpływające na amplitudy całej tej struktury. Jeżeli algorytm został dobrze skonstruowany, niepożądane składniki mogą częściowo się wygaszać, natomiast amplituda odpowiadająca interesującej właściwości może wzrastać.
Można porównać to do odpowiednio przygotowanych fal, które nie są analizowane pojedynczo. Zamiast sprawdzać każdą falę osobno, doprowadzamy do ich spotkania w taki sposób, aby w określonych miejscach się wzajemnie wzmacniały, a w innych osłabiały. Po zakończeniu procesu patrzymy na powstały wzór i wyciągamy z niego potrzebną informację.
Oczywiście rzeczywisty algorytm kwantowy jest opisany algebrą liniową i mechaniką kwantową, a nie falami na jeziorze, jednak ta analogia znacznie lepiej oddaje znaczenie interferencji niż popularny obraz maszyny „próbującej wszystkich odpowiedzi jednocześnie”.
Czy komputer kwantowy wykorzystuje sztuczną inteligencję?
Komputery kwantowe i sztuczna inteligencja są odrębnymi technologiami, mimo że często pojawiają się razem w prognozach dotyczących przyszłości informatyki. Model AI uruchomiony na GPU nie staje się systemem kwantowym, podobnie jak procesor kwantowy nie jest automatycznie sztuczną inteligencją.
Naukowcy badają jednak możliwość wykorzystania algorytmów kwantowych do wybranych problemów związanych z uczeniem maszynowym. Powstała cała dziedzina określana jako quantum machine learning, w której analizuje się między innymi kwantowe sposoby reprezentowania danych i wykonywania określonych operacji matematycznych.
Najważniejszym pytaniem pozostaje jednak to, czy dane podejście oferuje praktyczną przewagę po uwzględnieniu całego kosztu przygotowania danych, uruchomienia obwodu, korekcji błędów i odczytu rezultatu. Klasyczne GPU oraz specjalizowane akceleratory AI również rozwijają się bardzo szybko, dlatego samo stworzenie kwantowego odpowiednika operacji nie oznacza jeszcze, że będzie on korzystniejszy.
Bardziej prawdopodobna jest współpraca różnych typów sprzętu, w której CPU, GPU, akceleratory AI i procesory kwantowe wykonują te fragmenty zadania, do których są najlepiej dostosowane. Komputer kwantowy należy więc traktować jako potencjalnie nową klasę wyspecjalizowanego narzędzia obliczeniowego, a nie bezpośredniego następcę każdego istniejącego procesora.
Czy komputer kwantowy działa już dzisiaj?
Komputery kwantowe są rzeczywistymi, działającymi urządzeniami, a nie wyłącznie koncepcją teoretyczną. Istnieją procesory kwantowe wykorzystujące różne rodzaje kubitów, a część z nich można programować zdalnie za pośrednictwem usług chmurowych. Microsoft Azure Quantum jest przykładem platformy umożliwiającej dostęp do różnych technologii obliczeń kwantowych.
Nie oznacza to jednak, że dysponujemy już uniwersalnym, odpornym na błędy komputerem kwantowym rozwiązującym wszystkie problemy, o których mówi teoria. Dzisiejsze systemy pozostają ograniczone między innymi przez błędy, czas koherencji, skalę procesorów i trudności związane z wykonywaniem bardzo długich obwodów.
Dlatego obecna generacja sprzętu jest wykorzystywana przede wszystkim do badań, testowania algorytmów, rozwijania technologii kubitów oraz eksperymentów nad korekcją błędów i skalowaniem systemów.
Granica pomiędzy demonstracją naukową a komputerem posiadającym praktyczną przewagę ekonomiczną zależy również od konkretnego problemu. Sam fakt wykonania obliczenia, które jest trudne do symulowania klasycznie, nie oznacza jeszcze, że maszyna kwantowa rozwiązuje wartościowy problem biznesowy szybciej i taniej od najlepszych istniejących metod.
FAQ – jak działa komputer kwantowy?
Jak działa komputer kwantowy w jednym zdaniu?
Co to jest kubit?
Czy kubit naprawdę jest jednocześnie zerem i jedynką?
Czy komputer kwantowy liczy wszystko jednocześnie?
Czy komputer kwantowy złamie internet?
Czy komputer kwantowy zastąpi superkomputery?
Do czego może służyć komputer kwantowy?
Podsumowanie i wnioski
Jak działa komputer kwantowy? Jego działanie opiera się na wykorzystaniu mechaniki kwantowej do reprezentowania i przekształcania informacji w sposób, którego nie potrafi bezpośrednio naśladować klasyczny bit. Podstawową jednostką informacji jest kubit, a najważniejszymi mechanizmami umożliwiającymi tworzenie algorytmów kwantowych są superpozycja, splątanie i interferencja.
Komputery kwantowe nie są uniwersalnym zamiennikiem dzisiejszych procesorów i nie sprawią, że każda aplikacja zacznie działać tysiące razy szybciej. Ich znaczenie może być ogromne w tych obszarach, w których istnieją problemy szczególnie dobrze pasujące do algorytmów kwantowych, między innymi w symulowaniu materii, chemii, nauce o materiałach oraz niektórych problemach matematycznych.
Największym wyzwaniem pozostaje stworzenie maszyn zdolnych do wykonywania bardzo długich obliczeń z odpowiednio małym poziomem błędów. Kubity są podatne na dekoherencję i zakłócenia, dlatego rozwój sprzętu musi iść w parze z coraz skuteczniejszą korekcją błędów kwantowych. Dopiero połączenie odpowiedniej liczby kubitów logicznych, wysokiej jakości bramek i skalowalnej architektury pozwoli w pełni wykorzystać możliwości przewidywane przez teorię.
Komputer kwantowy najlepiej traktować więc nie jako „superszybki komputer przyszłości”, lecz jako nowy rodzaj maszyny obliczeniowej, która posługuje się innymi zasadami niż klasyczna elektronika i może otworzyć drogę do rozwiązywania wybranych problemów pozostających poza praktycznym zasięgiem tradycyjnych metod.
Źródła: NIST, Microsoft Quantum, Azure Quantum, IBM Quantum, NIST Post-Quantum Cryptography. Opracowanie własne.
Dziękujemy za przeczytanie artykułu na Techoteka.pl.
Codziennie publikujemy najważniejsze informacje z Polski i ze świata dotyczące technologii, sztucznej inteligencji, nowych rozwiązań cyfrowych oraz trendów technologicznych, które kształtują przyszłość.
Obserwuj nas na Facebooku, aby być na bieżąco z najważniejszymi wydarzeniami ze świata technologii.